RK3588 NPU 模型部署:从 RKNN 工具链到 6 TOPS 的真实算力
规格书上的「6 TOPS」和实际能跑出多少帧,中间隔着一整条工具链。不少团队买回 RK3588 板子后才发现,模型能不能落地,取决于转换、量化和算子支持,而不是那个数字。
先明确 6 TOPS 意味着什么
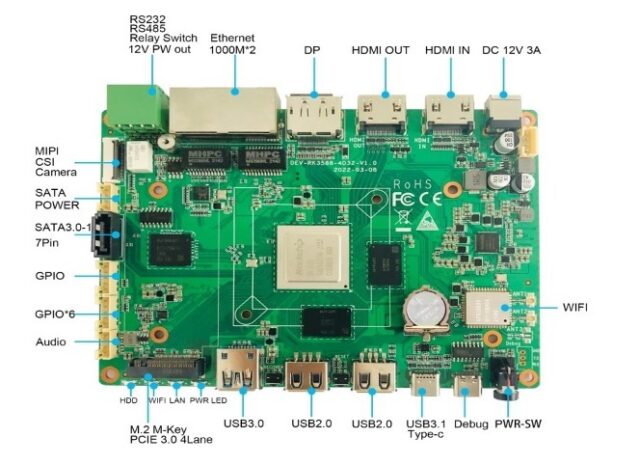
RK3588 内置的 NPU 算力为 6 TOPS,支持 RKNN 与 TensorFlow Lite。01B EDGE-RK3588-4D32 V1.2A 采用八核 CPU、8K 编解码与这颗 NPU,配置 4GB DDR + 32GB eMMC,是比较标准的验证平台。
这个算力档位的现实定位是:目标检测、人脸识别、视频结构化、姿态估计这类中小模型可以流畅运行;大语言模型不行。选型前先确认模型规模,比事后优化更省时间。
工具链是真正的门槛
RKNN 工具链的流程是:模型(ONNX / TensorFlow / PyTorch 导出)→ 转换 → 量化 → 板上推理。每一步都有容易卡住的地方。量化环节尤其关键:INT8 量化能显著提升速度,但精度损失是否可接受,必须在自己的数据集上实测,不能只看通用指标。
算子支持也是常见问题。模型里如果有 NPU 不支持的算子,会被回退到 CPU 执行,结果是整体速度被那几个算子拖住。遇到这种情况,通常需要改写网络结构,而不是硬跑。
接口与场景匹配
01A RP01A-RK3588S-5D32 基于 RK3588S(8nm、八核 4×Cortex-A76 + 4×Cortex-A55),支持 8K 60Hz 输出与解码,内置 6.0 TOPS NPU,接口侧重视觉与语音:双路 MIPI 摄像头输入,6 路 MIC + 2 路 AEC 回声消除输入。做视频物体识别或语音识别的项目可以直接用上,省掉外围设计。
落地建议
建议的顺序是:先用现成开发板跑通一个最小可用的模型,把工具链和精度问题解决掉,再考虑硬件定制。反过来做,往往会在硬件已经定型后才发现模型跑不动。规格与资料见 EDGE-RK3588-4D32 产品页。